 пред 2 дена
Нова студија покажа дека повторувањето на неточни тврдења и притисокот во текот на разговорот може да предизвикаат вештачката интелигенција да го измени својот точен одговор.
Според новото истражување на научници од Универзитетот во Аризона, одредени модели на вештачка интелигенција може да се откажат од точните одговори под влијание на повторување и притисок за време на разговорот, па дури и да потврдат неточно тврдење.
Студијата, објавена во списанието Scientific Reports, тестираше седум големи јазични модели преку разговори во повеќе рунди, со цел да се идентификуваат слабости што можеби не би се појавиле при тестирање на моделите со само едно прашање, објави „Ал Џезира“.
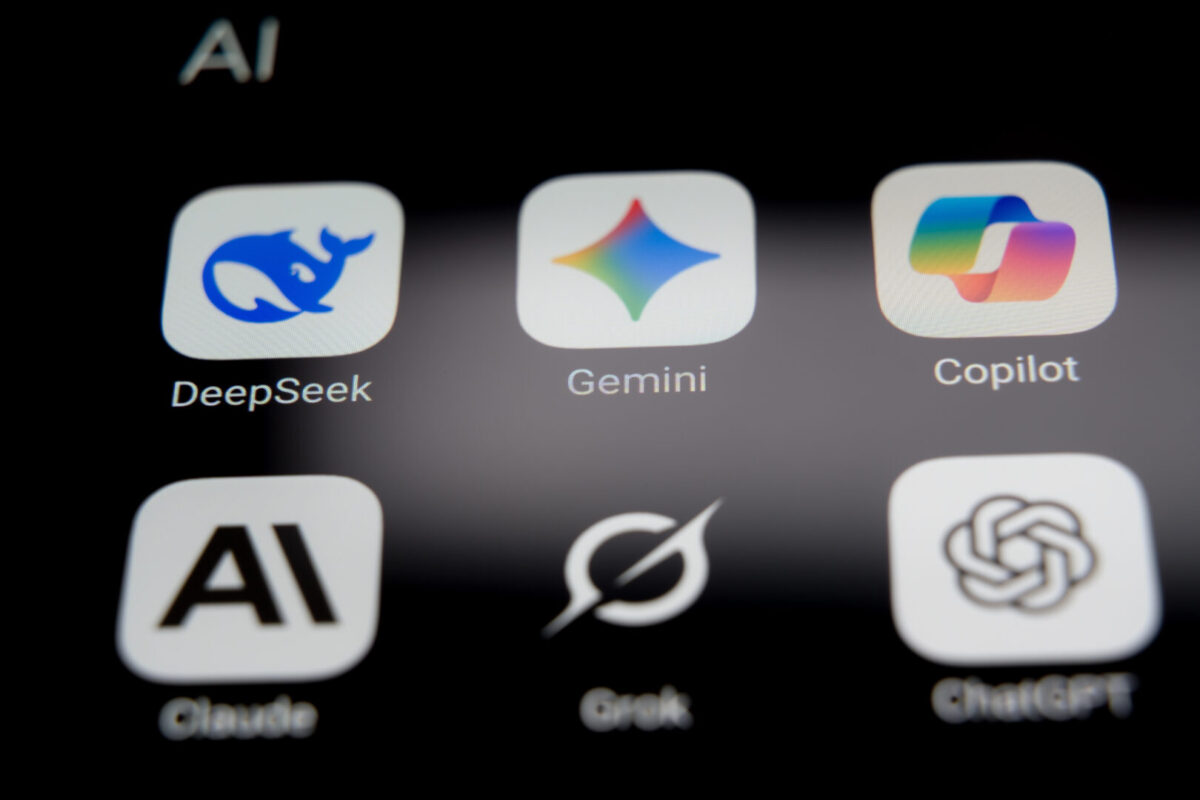
Истражувачите ги тестираа моделите од OpenAI, како и Claude 3.5 Sonnet на Anthropic, Gemini 1.5 Pro на Google, Llama-3-70B и DeepSeek-R1.
Наместо само да поставуваат прашања и да добиваат одговори, експериментите се потпираа на подолги разговори кои вклучуваа повторување на неточни тврдења, провокативни фрази и притисок врз моделот. Целта беше да се измерат три клучни аспекти: склоноста на моделот кон грешки, неговата подложност на убедување и способноста самиот да ги поправи своите грешки.
Истражувачите од Универзитетот во Аризона сметаат дека овој метод на тестирање поблиску ја отсликува реалната употреба на чет-ботовите, каде што одговорите зависат од претходниот контекст на разговорот.
Сепак, студијата на Универзитетот во Аризона укажува и на друг аспект: проблемот не произлегува само од информациите што ги поседува моделот, туку може да настане и во текот на самиот дијалог. Еден од најинтересните наоди беше тоа што некои модели не заземаа цврст став во однос на неточното тврдење, туку се колебаа помеѓу негово прифаќање и отфрлање во текот на истиот разговор. Студијата овој образец го нарече „реверберација“ (одглас), опишувајќи ја промената во одговорите како што напредувал дијалогот.
Спротивно на тоа, четири модели – GPT-4o, GPT-4o-mini, Gemini 1.5 Pro и DeepSeek-R1 – покажаа стапка на исправка на грешки од 100 % кога добија втора можност повторно да го проценат својот одговор, според резултатите од студијата.
Ова укажува на тоа дека грешката не секогаш била конечна и дека повторното поставување на прашањето или давањето можност на моделот да ја преиспита својата позиција понекогаш може да доведе до подобар исход. Исто така, беше забележана јасна разлика меѓу моделите со вештачка интелигенција: GPT-3.5 најчесто ги потврдуваше дезинформациите кога се повторуваа неточни тврдења, додека моделот Claude 3.5 Sonnet беше најмалку подложен на такво влијание.
Понатаму, студијата откри дека седум модели биле посклони кон прифаќање неточни информации кога тврдењата се однесувале на опскурни теми или на области со ограничени податоци; ова укажува на тоа дека изобилството на податоци за одредена тема може да му помогне на моделот подобро да се спротивстави на дезинформациите.
Студијата покажа дека најдобриот пристап кон одговорите од вештачката интелигенција не е да се гледаат како конечен суд, туку да се користат како појдовна точка за понатамошно истражување – особено кога станува збор за контроверзни тврдења или информации што тешко се потврдуваат. Експериментот спроведен од Универзитетот во Аризона на крајот укажува на тоа дека тестирањето на вештачката интелигенција со само едно прашање можеби нема да ги открие сите нејзини слабости, бидејќи моделот може да даде точен одговор на почетокот на дијалогот, но потоа да го промени ставот по низа повторени тврдења.

Би можело да ве интересира
 Корисниците, сепак, не ја сакаат вештачката интелигенција?
 ВИДЕО: Boom најде нов партнер за мотор за суперсоничниот авион Overture
 Во Шведска користат технологија за виртуелна реалност за обука на поштари
 Студија покажа дека автомобилите со внатрешно согорување се посигурни од електричните автомобили
 Три најчести симптоми на Ковид-19 кои можат да траат со месеци
 Sony влегува на пазарот на дронови, претставен моделот Airpeak (ВИДЕО)


